GPU 낭비 너무 심해…포스텍 창업지원 받은 고교생의 해법은
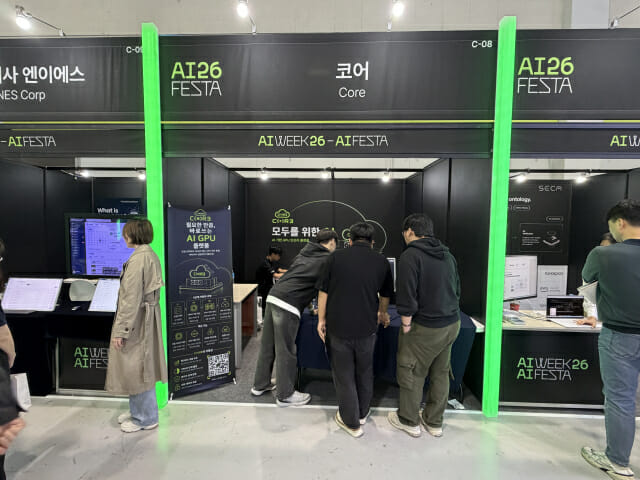
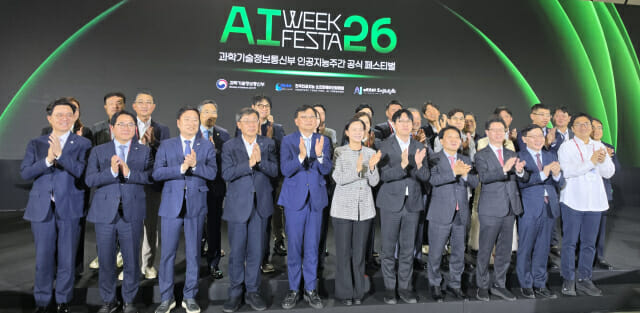
인공지능(AI) 모델을 구동하는 데 6.5GB만 필요해도 10GB를 통째로 배정받아야 한다면, 남은 3.5GB는 다른 사용자가 쓸 수 없다. 마이스터고 재학생들은 교내 GPU 서버에서 반복된 이 문제를 해결하기 위해 직접 자원 관리 플랫폼을 만들었다. 포스텍 창업지원을 받은 고교생 중심 팀 '코어(CORE)'는 6일 서울 코엑스 C홀에서 개막한 'AI 페스타 26'에서 AI 모델 구동에 필요한 자원을 계산하고, 남는 GPU 자원을 다른 사용자에게 배분하는 플랫폼을 선보였다. 코어는 모델 선택부터 GPU 배포, 채팅과 애플리케이션 프로그래밍 인터페이스(API) 연결까지 지원하는 GPU 자원 플랫폼을 개발 중이다. AI 모델별 실행 조건에 맞춰 필요한 비디오램(VRAM) 용량을 예측하고, 관리자가 실제 자원 현황을 고려해 배포를 승인하는 방식이다. 코어는 마이스터고 재학생들이 주축이다. 1·2학년 학생들이 개발을 맡고, 3학년 학생은 멘토 역할로 참여하고 있다. 팀은 올해 중순 포스텍 창업지원 프로그램에 지원해 약 2000만원 지원을 받고 서비스 개발을 시작했다. 개발 배경은 교내 GPU 서버 운영 방식이다. 학교에는 슈퍼 GPU 서버 4대가 있지만, 기존에는 사용자에게 10기가바이트(GB) 단위로 GPU 메모리를 고정 배정하는 방식이 적용됐다. 실제로 6.5GB만 필요한 작업에도 10GB를 할당하면 남은 3.5GB가 활용되지 못하는 문제가 발생했다. 코어 관계자는 "학교 GPU 서버에 남는 자원이 있는데도 고정 할당 방식 때문에 필요한 학생이 쓰지 못하는 문제가 있었다"며 "모델별 필요 자원을 계산해 더 많은 사람이 GPU를 활용할 수 있도록 하는 것이 목표"라고 말했다. 코어는 사용자가 AI 모델 종류와 컨텍스트 길이, 동시 처리 요청 수 등을 입력하면 시스템이 구동에 필요한 VRAM 용량을 계산한다. 이후 관리자가 서버의 예약량과 실제 사용량, 남은 자원을 확인해 배포 요청을 승인하는 방식이다. 고정된 슬롯 수가 아니라 모델별 메모리·연산 자원과 서버 여유를 기준으로 자원을 배정하는 것이 특징이다. 사용자는 허깅페이스 URL이나 저장소 ID를 통해 오픈소스 거대언어모델(LLM)을 불러오고, 원본 또는 양자화 모델을 선택해 배포 조건을 설정할 수 있다. 파일 준비와 승인 절차를 거치면 GPU 서버에서 컨테이너가 실행되며, 이후 스트리밍 방식의 채팅과 API로 모델을 사용할 수 있다. 코어는 현재 큐원(Qwen) 2.5-7B-Instruct와 스몰LM2-1.7B-Instruct 등 일부 오픈소스 AI 모델을 실제 GPU 서버에서 구동해 채팅 기능까지 확인했다. 다만 허깅페이스에 공개된 모든 AI 모델을 곧바로 쓸 수 있는 것은 아니다. 모델 형식과 서버 사양이 맞는지, 실행에 필요한 자원이 충분한지를 먼저 확인해야 한다. 팀은 관리자용 대시보드에서 GPU 메모리 예약량과 실제 사용량, 이용률, 상태 정보를 확인하도록 구현했다. 같은 모델 파일을 다시 사용할 경우 반복 다운로드를 줄이는 기능과 배포 과정의 상태 메시지·컨테이너 로그 확인 기능도 포함했다. 코어는 11월 중 학교에서 서비스를 사용할 수 있도록 개발을 마무리하는 것을 목표로 잡았다. 향후에는 지원 모델을 확대하고 터미널·파이썬 환경, 파인튜닝과 학습 기능, 사용량 기반 과금과 유휴 자원 자동 재배분 기능 등을 단계적으로 검토할 계획이다. 한편 AI 페스타 26은 과학기술정보통신부가 주최하고 한국인공지능·소프트웨어산업협회(KOSA), AI페스타조직위원회가 주관한다. 과기정통부 'AI 주간 2026' 대표 행사로, 'AI, 현실이 되다. 모두의 AI'를 슬로건으로 8일까지 열린다. 행사에는 국내외 AI 기업·기관 350여 곳이 참여해 500여 개 부스를 운영한다.