메타 연구원, AI 시대 3D 그래픽스 새 무대로 '로봇' 지목
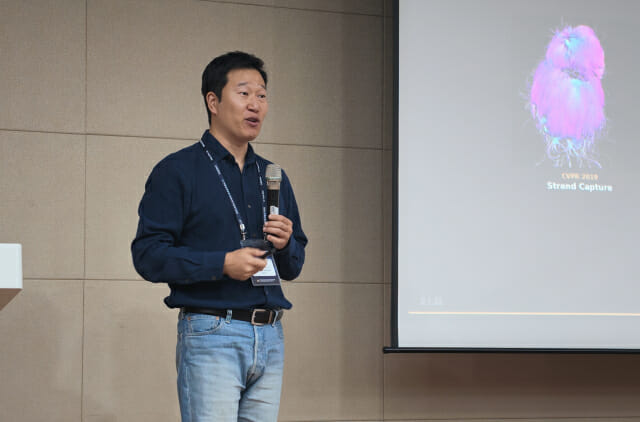
생성형 인공지능(AI)이 영상 제작의 영역을 빠르게 넓히면서 3차원(3D) 그래픽스 기술의 무게중심이 로봇과 자율주행 등 현실 세계로 이동하고 있다. 남길주 메타 리얼리티 랩스 연구원은 20일 고려대 하나스퀘어에서 열린 'AI 테크 데이 2026'에서 영상 제작에 쓰이던 기존 그래픽스 기술이 생성형 AI에 빠르게 자리를 내주고 있다고 진단했다. AI가 복잡한 3D 모델 없이도 사실적인 영상을 만들어내면서 3D 기술의 새로운 활용 분야로 로봇과 자율주행을 꼽았다. 컴퓨터 그래픽스는 영화나 게임에서 사람과 사물을 실제처럼 표현하는 데 활용돼 왔다. 기존에는 인물과 사물의 3D 형태를 만들고 움직임과 빛의 반사 등을 계산해 영상을 구현했다. 생성형 AI는 이러한 과정을 일일이 거치지 않아도 원하는 장면을 만들어낸다. 방대한 이미지와 영상을 학습한 뒤 글로 입력한 요청에 맞춰 새로운 영상을 생성하는 방식이다. 생성형 AI가 구현하는 수준도 빠르게 높아지고 있다. 초기에는 주로 사람 얼굴을 생성했지만 이후 복잡한 배경과 빛의 반사까지 자연스럽게 표현하기 시작했다. 오픈AI의 영상 생성 AI '소라'는 사람의 걸음걸이와 주변 환경을 사실적으로 구현했고 최근에는 인물의 표정과 동작까지 제어하는 기술도 등장했다. 남 연구원은 이러한 변화를 AI 연구자 리처드 서튼의 '쓰라린 교훈(The Bitter Lesson)'과 연결했다. 사람이 정교하게 규칙을 설계하는 방식보다 대규모 연산을 활용해 AI가 스스로 학습하도록 하는 방식이 장기적으로 더 높은 성과를 냈다는 내용이다. 그 역시 약 5년간 머리카락을 3D로 복원하는 기술을 연구하다 접근법을 바꿨다. 복잡한 그래픽스 기술을 직접 설계하는 대신 기본적인 지식만 적용하고 나머지는 AI가 데이터에서 학습하도록 했다. 그 결과 기존 방식보다 좋은 성과를 얻었다고 설명했다. 이 같은 변화는 3D 기술의 활용 분야에도 영향을 미치고 있다. 남 연구원은 최종 결과물이 이미지나 영상이라면 반드시 3D 모델을 만들 필요는 없다고 설명했다. 생성형 AI만으로도 원하는 결과물을 얻을 수 있는 경우가 늘고 있기 때문이다. 로봇과 자율주행은 다르다. 화면에 사람의 움직임을 자연스럽게 표현하는 것과 로봇이 실제 물건을 집는 일은 별개다. 로봇이 물건을 정확하게 집으려면 물체의 위치와 형태, 주변 공간을 파악해야 한다. 자율주행차 역시 장애물과 다른 차량의 위치와 움직임을 이해해야 한다. 이러한 과정에서 3D 공간과 물리 현상을 다루는 기술이 활용된다. 제조업의 3D 설계와 물리 시뮬레이션, 광학과 과학 연구도 그래픽스 기술이 필요한 분야로 꼽았다. 남 연구원은 2020년부터 메타 리얼리티 랩스에서 컴퓨터 비전과 3D 그래픽스 기술을 연구해 왔다. 최근에는 디지털 휴먼과 영상 구현을 넘어 로봇과 피지컬 AI로 연구 영역을 넓히고 있다. 기존에 축적한 3D 기술을 실제 물리 세계에서 작동하는 AI에 활용하는 방향이다. 남 연구원은 "영상 제작에서 그래픽스의 역할이 예전만큼 크지 않다"며 "그래픽스로 세상을 디지털화해 피지컬 AI와 로봇, 자율주행 발전에 기여하는 것이 새로운 비전"이라고 말했다.