• ZDNet USA
  • ZDNet China
  • ZDNet Japan
  • English
  • 지디넷 웨비나
뉴스
  • 최신뉴스
  • 방송/통신
  • 컴퓨팅
  • 홈&모바일
  • 인터넷
  • 반도체/디스플레이
  • 카테크
  • 헬스케어
  • 게임
  • 중기&스타트업
  • 유통
  • 금융
  • 과학
  • 디지털경제
  • 취업/HR/교육
  • 생활/문화
  • 인사•부음
  • 글로벌뉴스
  • AI의 눈
ZDPick
국감2026
인공지능
IT'sight
칼럼•연재
포토•영상

ZDNet 검색 페이지

'말리'통합검색 결과 입니다. (4건)

  • 태그
    • 제목
    • 제목 + 내용
    • 작성자
    • 태그
  • 기간
    • 3개월
    • 1년
    • 1년 이전

모바일 SoC, AI 처리 중심 NPU→GPU로 확장

온디바이스·엣지AI의 핵심 연산을 담당해온 모바일용 시스템반도체(SoC)의 AI 가속 구조가 신경망처리장치(NPU) 중심에서 GPU를 함께 활용하는 방향으로 바뀌고 있다. 생성 AI와 거대언어모델(LLM), 에이전틱 AI 등 처리해야 할 AI 작업이 한층 다양해지며 병렬 연산에 강점을 가진 GPU의 역할이 커진 것이다. 퀄컴과 Arm은 최근 GPU에 AI 연산 전용 신경망 가속기를 통합했고, 애플도 M5에 이어 차세대 아이폰용 A20 프로 GPU에 신경망 가속기를 적용했다. 퀄컴과 Arm, 애플이 잇따라 GPU에 AI 전용 가속기를 통합하는 것은 이처럼 AI 연산의 일부를 GPU로 분산해 복잡한 AI 작업에 대응하려는 전략으로 해석할 수 있다. 퀄컴, 차세대 아드레노 GPU에 AI 연산 접목 퀄컴은 모바일용 스냅드래곤8 엘리트, PC용 스냅드래곤X2 엘리트 등 SoC 제품에서 그동안 NPU의 AI 처리 성능과 전력 효율을 강조해왔다. 여러 AI 모델이 동시에 작동하는 환경에서는 전력 효율이 높은 NPU가 모바일·PC AI의 핵심 경쟁력이라는 취지였다. 그러나 퀄컴은 이달 2일 아드레노 GPU에 AI 처리 전용 코어인 '아드레노 매트릭스 코어(AMC)'를 추가한다고 밝혔다. 고성능 AI 연산에 필요한 기능을 NPU나 CPU에 넘기지 않고 GPU 내부에서 직접 처리한다는 것이다. 퀄컴은 AI 처리를 GPU에서 직접 수행하는 것이 아드레노 GPU 역사상 처음이라고 설명했다. 이를 통해 개발자들이 복잡한 렌더링 모델을 보다 낮은 지연시간과 전력으로 수행할 수 있다는 설명이다. Arm도 말리 G2-울트라 NX GPU에 AI 연산 추가 모바일용 SoC의 설계자산(IP)을 공급하는 영국 Arm도 이달 8일 프리미엄 스마트폰과 태블릿, PC 등 모바일 기기를 겨냥한 새로운 반도체 IP '모바일용 CSS 2'를 공개했다. 모바일용 CSS 2는 각종 연산작업을 수행하는 C2 CPU와 그래픽 및 AI 가속을 담당하는 말리 G2-울트라 NX GPU로 구성된다. 이중 말리 G2-울트라 NX GPU에는 신경망 가속기가 통합됐다. Arm은 GPU에 통합된 신경망 처리 기능을 이용해 저해상도 화면을 고해상도로 보정하는 신경망 슈퍼샘플링(NSS), 초당 30프레임 화면을 60프레임 수준으로 높이는 신경망 프레임 업스케일링 등을 구현할 수 있다고 밝혔다. 이는 GPU가 그래픽과 AI 연산을 보다 긴밀하게 처리하도록 하는 구조다. Arm은 말리 G2-울트라 NX GPU의 실제 AI 처리 성능을 약 10~20 TOPS 내외로 예상했다. 애플, M5 이어 A20 프로 GPU에도 신경망 가속기 추가 애플은 2017년 아이폰8·X에 탑재한 SoC 'A11 바이오닉'에 NPU인 뉴럴 엔진을 처음 통합하고 사진·음성·자연어 처리 등 특정 AI 연산에 활용했다. 애플 역시 최근에는 GPU의 AI 처리 능력을 강화하고 있다. 지난해 10월 공개한 아이패드 프로·맥용 SoC M5의 GPU에 신경망 가속기를 통합한 데 이어 차세대 아이폰용 A20 프로도 GPU에 신경망 가속기를 적용했다. A20 프로의 GPU는 전 세대보다 1개 많은 7개 코어로 구성되며, GPU 내부에 신경망 가속기를 내장해 FP8(8비트 부동소수점) 연산 성능을 최대 두 배 높였다. A20 프로는 GPU와 별개로 NPU 역할을 하는 32코어 뉴럴 엔진도 함께 탑재한다. 저전력으로 지속적으로 실행해야 하는 AI 작업은 여전히 뉴럴 엔진이 담당하지만 높은 연산 성능이 필요한 AI 작업에서 GPU의 역할을 강화한 것이다. GPU 병렬 연산, 복잡한 AI 처리에 적합 NPU는 주위 소리 확인, 음성 인식 등 저전력으로 지속 처리가 필요한 작업에 적합하다. 그러나 AI 모델의 크기가 커지고 연산 과정이 복잡해지면서 NPU만으로 모든 AI 작업을 빠르게 처리할 수 없게 됐다. 특히 모바일 기기에서 구동되는 스테이블 디퓨전·플럭스 계열 이미지 생성, 거대언어모델(LLM), AI 영상 생성·변환, 실시간 AI 이미지 편집 등은 대규모 병렬 연산과 높은 메모리 대역폭을 요구하는 대표적인 사례다. 이런 작업에서는 GPU가 가진 높은 병렬 연산 능력과 메모리 대역폭, 다양한 연산을 유연하게 수행할 수 있는 구조가 장점으로 작용한다. 2나노급 공정으로 GPU 확대 여유 증가 모바일 SoC는 PC/서버용 프로세서와 달리 스마트폰 내부의 제한된 면적을 활용해 CPU·GPU·NPU 등 주요 연산 블록을 집적하는 구조다. 때문에 특정 연산 장치를 대폭 강화하기 어려웠다. 이달 공개된 차세대 모바일 SoC는 모두 TSMC N2와 삼성전자 SF2 등 2나노급 공정을 염두에 둔 제품들이다. 2나노급 공정 도입에 따른 트랜지스터 집적도 향상은 이들 연산 블록을 확대할 수 있는 설계 여유를 제공한다. TSMC에 따르면 N2는 N3E(3나노급) 대비 동일 면적에서 15% 이상 높은 트랜지스터 밀도를 제공한다. 이를 단순히 면적에 환산하면 동일한 회로를 구현할 때 이론적으로 약 13%의 면적을 줄일 수 있는 수준이다. GPU+AI 결합 모바일 SoC, 이 달부터 시장 진입 새로운 GPU를 통합한 모바일용 SoC는 올해 애플 아이폰18 프로와 아이폰 듀오를 시작으로 내년 퀄컴과 미디어텍 등 주요 제조사를 통해 스마트폰과 태블릿에 투입될 예정이다. 이에 따라 모바일 AI의 성능을 평가하는 기준도 변화할 가능성이 커졌다. 지금까지는 주로 NPU의 TOPS가 온디바이스 AI 성능을 나타내는 주요 지표로 활용됐지만, 앞으로는 GPU 내 신경망 처리 기능을 활용한 그래픽 성능과 AI 연산 성능도 중요한 평가 기준으로 부상할 전망이다. 다만 GPU에 AI 가속기를 통합했다고 해서 실제 성능이 자동으로 향상되는 것은 아니다. 운영체제와 AI 프레임워크, 개발 도구가 새로운 가속기를 지원하고 개발자가 이를 활용하도록 모델과 소프트웨어를 최적화해야 한다.
2026.09.15 16:11권봉석 기자

Arm, 모바일용 CSS 2 공개... 말리 GPU에 신경망 가속기 통합

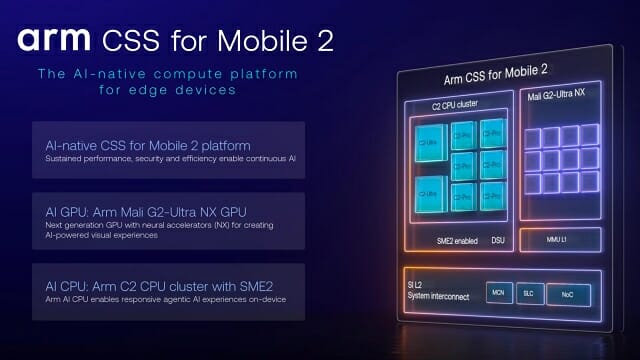
영국 반도체 설계 전문기업 Arm이 8일 중국 상하이에서 진행되는 기술행사 'Arm 에브리웨어 차이나 2026'에서 프리미엄 스마트폰과 태블릿, PC 등 모바일 기기를 겨냥한 새 반도체 설계자산(IP) '모바일용 CSS 2'를 공개했다. 7일 진행된 사전 브리핑에서 크리스 버기 Arm 엣지 AI 사업부문 총괄 수석부사장(EVP)은 "과거 AI는 대부분의 작업을 클라우드에서 진행해야 했지만 앞으로는 AI가 이용자의 의중을 파악해야 한다"고 설명했다. 이어 "이런 작업을 지연시간을 단축하면서 경제적으로 수행하려면 많은 작업을 클라우드가 아닌 엣지로 배치해야 한다. 모바일용 CSS 2는 엣지에서 AI 응용프로그램을 효율적으로 구동할 수 있는 IP"라고 덧붙였다. 모바일용 CSS 2, C2 CPU·말리 G2 GPU로 구성 모바일용 CSS 2는 각종 연산작업을 수행하는 C2 CPU, 그리고 그래픽과 AI 가속을 처리하는 말리 G2 GPU 등 두 개 파트로 구분된다. Arm은 사전 브리핑에서 새로 탑재될 말리 G2-울트라 NX GPU 설명에 많은 부분을 할애했다. PC GPU는 이미 AI 가속기를 활용해 업스케일링과 프레임 생성에 활용해 왔다. 반면 Arm 계열 시스템반도체(SoC) 제조사는 그간 GPU에 조명효과를 처리하는 레이트레이싱 기술만 구현해 왔다. 과거 데스크톱용 GPU에서만 가능했던 기능을 모바일에서도 저전력으로 구현했다는 점에서는 여전히 의미가 있다. 그러나 레이트레이싱은 게임 화면 표현력을 더하는 기술일 뿐 GPU의 연산 부담을 덜어주지는 못한다. 모바일 환경에서 AI 기반 렌더링 지원 Arm은 지난 6월 게임 스튜디오 스모 디지털과 함께 제작한 게임 '뉴럴 던' 시연을 통해 신경망 가속기를 결합한 렌더링 기술을 일부 공개하기도 했다. 크리스 버기 총괄부사장은 "말리 G2-울트라 NX는 말리 GPU 사상 최초로 AI에 중점을 뒀다. 신경망 가속기를 GPU에 내장해 소비전력 1W 수준에서 구현했다"고 설명했다. 이어 "960×540 화소 화면을 두 배 수준인 1920×1080 화소로 끌어올리는 신경망 슈퍼샘플링(NSS), 초당 30프레임 화면을 두 배인 60프레임으로 높이는 신경망 프레임 업스케일링, 화면 노이즈를 줄이는 신경망 슈퍼샘플링·디노이징(NSSD) 등 기술을 지원한다"고 설명했다. 내부 처리 개선 더해 초당 프레임 수 최대 4배 향상 크리스 버기 총괄부사장은 "신경망 처리 기술과 함께 그래픽 명령어를 실행하는 '실행 엔진'도 7세대로 재설계됐고 레이트레이싱 처리 유닛도 업그레이드했다. 이를 통해 초당 프레임 수와 처리 효율은 최대 4배 높였다"고 설명했다. 이어 "게임 개발사는 과거 모바일용 게임 개발시 그래픽 수준을 최적화하느라 많은 시간을 보냈지만 이제는 게임의 스토리에 더 집중할 수 있게 됐다"고 자평했다. 말리 G2-울트라 NX의 신경망 렌더링은 언리얼엔진5와 유니티 등 상용 게임 엔진에서 지원될 예정이다. 크리스 버기 총괄부사장은 "이는 시작에 불과하며 더 많은 게임으로 지원을 확대해 최신 모바일 게임에서 유용성을 확인할 수 있을 것"이라고 말했다. C2 울트라 CPU, 단일코어 성능 최대 15% 향상 모바일용 CSS 2의 CPU는 최고 성능을 내는 C2 울트라 CPU, 전력 효율에 중점을 둔 C2 프로 CPU 등 총 두 종류를 포함한 'C2 CPU 클러스터'로 묶인다. C2 CPU도 이전 세대와 마찬가지로 AI 연산에 주로 쓰이는 행렬 곱셈 등 연산을 처리하기 위한 SME2 명령어 처리를 지원한다. 크리스 버기 총괄부사장은 "C2 울트라 CPU는 전작 대비 단일코어 처리 성능을 최대 15%, 다중작업 성능을 최대 12% 높여 에이전틱 AI가 요구하는 성능 향상에 부합했다"고 밝혔다. 이어 "'결혼기념일 저녁 식사를 계획하고 예약하라'는 작업을 C1 울트라 CPU 2개(듀얼코어) 처리시 1.8초가 걸렸다면 C2 울트라 CPU 2개는 이를 1.6초에 처리한다. 여기에 SME2까지 적용할 경우 처리 시간은 1.4초 가량으로 더 확실한 체감 속도 향상이 이뤄질 것"이라고 설명했다. 크리스 버기 총괄부사장은 "구글플레이에 등록된 AI 앱의 95%는 CPU를 주로 활용한다. SME2 생태계는 지속 확장 예정이며 이 과정에서 성능 향상에 큰 도움을 줄 것"이라고 설명했다. "말리 G2-울트라 NX, 실제 AI 성능은 20 TOPS 수렴할 것" 모바일용 CSS 2는 전 세대와 마찬가지로 NPU는 포함하지 않았다. 그러나 GPU의 신경망 처리 기능 추가로 AI 처리 성능을 크게 향상시켰다. 자체 개발 NPU를 추가하거나 외부 NPU IP를 추가하는 것은 파트너사의 몫이다. 제임스 맥니븐 Arm 엣지 AI 사업부문 클라이언트 컴퓨팅 부사장은 "C2 CPU 클러스터의 AI 연산 성능은 SME2 활용을 가정하면 약 5~7 TOPS이며 말리 G2-울트라 NX의 AI 성능은 이론적으로는 최대 50 TOPS 급도 구현 가능하다"고 설명했다. 이어 "말리 G2-울트라 NX GPU의 실제 AI 처리 성능은 실제 SoC를 설계하는 파트너사의 목적이나 역량에 따라 달라질 것이다. 실제로는 약 10~20 TOPS 가량이 될 것"이라고 설명했다. 모바일용 CSS 2는 대만 TSMC의 2나노급 공정인 N2에 최적화됐다. 이를 활용한 모바일용 SoC는 내년부터 주요 파트너사를 통해 시장에 공급될 전망이다.

2026.09.08 11:00권봉석 기자

Arm "GPU에 AI 가속기 접목, 중저가폰 게임 성능 향상"

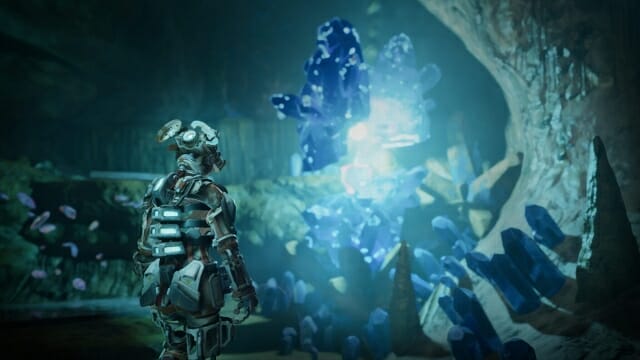
영국에 본사를 둔 반도체 설계자산(IP) 기업 Arm이 AI를 활용한 차세대 그래픽 기술 '뉴럴 렌더링(Neural Rendering)'을 공개했다. 모바일 게임 그래픽 품질 향상과 함께 Arm이 자체 개발한 GPU IP의 경쟁력 강화를 노렸다. 모바일 게임 업계는 그래픽 품질을 높일수록 전력 소모와 발열이 증가하는 근본적 문제 해결을 위해 노력해 왔다. Arm이 15일 공개한 모바일 게임 '뉴럴 던(Neural Dawn)'은 이런 한계를 극복하기 위해 뉴럴 렌더링을 전면에 내세웠다. 최신 모바일용 Arm GPU와 NPU, AI 기술을 결합해 CPU·GPU의 부하는 줄이고 배터리 소모와 발열을 줄일 수 있다는 것이 Arm 설명이다. 스마트폰 GPU 시장, 자체 GPU 경쟁 치열 시장조사업체 카운터포인트리서치에 따르면 올해 1분기 세계 스마트폰 SoC 시장 점유율은 미디어텍 32%, 퀄컴 23%, 애플 19%, 삼성전자 7% 순이다. 이 가운데 퀄컴은 수년 전부터 자체 설계 GPU인 아드레노를 발전시켜 왔고, 삼성전자는 AMD RDNA 아키텍처 기반 엑스클립스 GPU를 플래그십 제품에 적용하고 있다. 애플 역시 자체 GPU를 설계해 아이폰에 탑재한다. 반면 미디어텍은 대부분 제품군에서 Arm GPU IP를 활용한다. Arm 입장에서는 말리 GPU를 채택하는 제조사들의 경쟁력을 높이는 것이 중요하다. 최근 모바일 게임이 콘솔 수준의 그래픽을 요구하면서 GPU 성능 중요성이 더욱 커지고 있지만, 중저가 스마트폰은 전력과 발열, 제조 원가 문제로 플래그십 수준 GPU를 탑재하기 어렵다. Arm의 해법, AI 접목 '뉴럴 렌더링' Arm이 게임 스튜디오 스모 디지털과 함께 제작한 게임 '뉴럴 던'은 이러한 문제에 대한 해법을 제시한다. 뉴럴 던은 Arm의 최신 GPU 아키텍처인 이모탈리스(Immortalis)를 기반으로 제작됐다. 여기에 하드웨어 레이트레이싱과 향후 GPU에 탑재될 신경망 가속기를 결합한 뉴럴 렌더링 기술이 적용됐다. 원리는 PC 게임 분야에서 널리 쓰이는 AI 업스케일링 기술과 유사하다. GPU가 먼저 상대적으로 낮은 해상도로 화면을 생성한 뒤 AI 신경망 모델이 이를 분석해 고품질 이미지로 복원한다. 이를 통해 GPU 연산량을 줄이면서도 높은 해상도와 프레임을 유지할 수 있다. Arm은 여기에 스마트폰의 NPU를 일부 활용해 AI 관련 연산을 분산 처리하는 방안도 제시했다. 중저가 스마트폰 시장의 게임 경쟁력 강화에 방점 Arm의 말리 GPU 기반 뉴럴 렌더링 기술은 GPU 성능 여유가 상대적으로 적은 보급형·중급형 스마트폰에서 효과가 클 것으로 기대된다. 고가 스마트폰은 이미 강력한 GPU를 탑재해 고사양 게임 구동이 가능하다. 반면 중저가 스마트폰은 GPU 성능 제약으로 인해 그래픽 품질과 프레임 유지에 어려움을 겪는다. 뉴럴 렌더링은 GPU가 수행해야 할 작업을 줄이는 대신 AI를 활용해 화질을 보완한다. 같은 하드웨어에서도 더 높은 프레임과 그래픽 품질을 구현할 수 있는 것이다. 결국 Arm의 목표는 말리 GPU가 적용된 대중형 스마트폰의 게임 성능을 끌어올리는 데 있다. 모바일 GPU 성능 경쟁 역시 AI를 활용해 더 높은 프레임과 그래픽 품질을 구현하는 방향으로 이동할 수 있다. 언리얼엔진과 협력... 생태계 확대 추진 Arm은 이번 뉴럴 던 데모에서 언리얼엔진5의 차세대 조명 기술인 '메가라이트(MegaLights)'도 모바일 환경에서 구현했다. 메가라이트는 수백 개 광원을 효율적으로 처리해 보다 사실적인 빛과 그림자 효과를 구현하는 기술이다. 기존에는 PC나 콘솔 수준의 하드웨어가 필요한 기능으로 여겨졌다. Arm은 개발자들이 뉴럴 렌더링을 쉽게 활용할 수 있도록 언리얼엔진 개발사인 에픽게임스와 협력해 전용 플러그인을 제공할 예정이다. 또 오는 7월에는 Arm 신경망 그래픽 개발 키트도 업데이트할 계획이다.

2026.06.17 15:45권봉석 기자

Arm "루멕스 CSS, AI 처리 속도 최대 5배 강화"

영국 반도체 설계 전문기업 Arm은 지난 9월 프리미엄 스마트폰과 PC를 겨냥한 반도체 IP인 루멕스(Lumex) 컴퓨트 서브시스템(CSS)를 공개했다. CPU와 GPU, 이를 지원하는 소프트웨어와 개발자 도구를 통합해 주요 파운드리의 2, 3나노급 공정에서 고성능 시스템반도체(SoC) 개발을 돕는다. 21일 오후 국내 기자단과 만난 제임스 맥니븐 Arm 클라이언트 사업부 부사장은 "루멕스 CSS는 프리미엄 스마트폰에서 중간급 기기까지 AI 연산 성능을 손쉽게 강화할 수 있다"고 설명했다. 이어 "차세대 AI 응용프로그램 구동시 최고의 배터리 효율, 게임 등에서 최고의 시각적 경험을 위해 설계됐다. 루멕스 CSS를 활용하는 파트너사들이 CPU와 GPU를 요구사항에 맞게 자유롭게 조합할 수 있어 유연성이 극대화됐다"고 설명했다. C1 CPU IP, AI 처리 위한 SME2 명령어 내장 Arm은 고성능 처리가 필요한 CPU IP(지적재산권)로 코어텍스-X(Cortex-X)를, 중간/저전력 처리가 필요한 CPU IP로 코어텍스-A(Cortex-A)를 공급해 왔다. 루멕스 CSS에 포함된 CPU IP는 C1 클러스터로 기존 코어텍스-X, A를 대체한다. 성능과 배터리 지속시간, 효율과 예산 등에 따라 총 4개 코어를 용도에 맞게 선택할 수 있다. 제임스 맥니븐 부사장은 "C1 울트라 코어는 최고 성능을 내는 플래그십 CPU 코어로 전년 대비 성능을 25% 향상시켰다. C1 프리미엄은 울트라급 성능을 유지하면서 칩 면적을 35% 줄여 서브플래그십 기기에 적합하다. C1 프로와 나노는 전력 효율 중심의 설계로, 중보급형 제품군에 적합할 것"이라고 밝혔다. C1 CPU 코어에는 AI 연산에 주로 쓰이는 행렬 곱셈 등 연산을 처리하기 위한 SME2 명령어가 내장된다. 이를 이용해 음성인식, 번역, 생성 AI 등 각종 AI 처리 속도를 전세대 대비 5배 향상시켰다. 제임스 맥니븐 부사장은 "C1 CPU 코어를 묶은 클러스터는 SME2 명령어를 활용해 2-3GHz로 작동시 2-6 TOPS(1초당 1조번 연산)를 처리 가능하며 작동 속도 향상시 더 높아질 수 있다"고 설명했다. 더 큰 코어 크기로 전력을 더 많이 쓰는 인텔·AMD 등 x86 기반 프로세서의 CPU 코어는 통상 8-10 TOPS 정도의 성능을 낸다. 루멕스 CSS가 스마트폰 등 저전력 기기를 위한 반도체 IP인 것을 감안하면 전력 효율 면에서는 분명 우위에 있다. 말리 G1 울트라 GPU, 레이트레이싱 성능 2배 향상 루멕스 CSS에 포함된 새 GPU IP인 말리 G1 울트라는 그래픽과 AI 추론 성능이 각각 20% 향상, 프레임당 소비 전력은 9% 절감, 레이트레이싱(RT) 성능은 두 배 향상됐다. 빛과 사물 사이에 비치는 그림자, 반사광 등을 보다 현실에 가깝게 표현하는 레이트레이싱 기능은 과거 PC용 고성능 GPU에서만 가능한 기술로 간주됐다. 그러나 2022년부터 삼성전자(엑시노스 2200)와 퀄컴(스냅드래곤8 2세대) 등이 모바일 기기용 SoC에 레이트레이싱을 투입한 이후 모바일 기기의 GPU 성능을 파악하는 지표 중 하나로 레이트레이싱 성능이 자리잡았다. 이날 제임스 맥니븐 부사장도 말리 G1 울트라의 레이트레이싱 성능 향상을 특히 강조했다. 그는 "RTUv2 아키텍처는 단일 광선 추적 방식을 채택해 보다 현실감 있는 조명을 구현하며, 코어당 전용 RT 하드웨어를 탑재해 효율성과 성능을 모두 높였다"고 밝혔다. "내년 GPU 활용 AI 연산 가속 예정" 루멕스 CSS는 최근 공개된 타사 모바일 SoC와 달리 NPU(신경망처리장치)는 포함하지 않았다. 제임스 맥니븐 부사장은 "CPU에서 AI 연산을 처리하는 것이 오히려 더 지연 시간이 낮고 개발자들도 SME2 명령어를 보다 널리 활용할 수 있다"고 설명했다. 그러나 주요 반도체 제조사들은 상시 저전력 연산과 전처리 등에 강력한 성능을 내는 NPU와 함께 GPU도 동시에 강화하고 있다. 수 억개 매개변수(패러미터)로 구성된 거대언어모델(LLM) 등 처리에는 GPU의 성능이 더 필요하다. 제임스 맥니븐 부사장 역시 "말리 G1 울트라에 포함된 레이트레이싱 유닛은 불칸(Vulkan) API를 활용한 그래픽 처리에 최적화됐고 일부 API를 이용하면 이를 연산에도 활용할 수 있다"고 설명했다. 그는 이어 "GPU에 신경망(뉴럴) 관련 처리를 더해 AI 연산 성능을 강화하겠다는 취지를 지난 8월에 이미 밝힌 바 있다. 현재는 상세한 내용을 공개할 수 없지만 AI 처리 성능 처리 면에서 비약적인 발전이 있을 것"이라고 설명했다.

2025.10.22 15:35권봉석 기자

  Prev 1 Next  

지금 뜨는 기사

이시각 헤드라인

삼성전자, 테일러 1공장 후속 설비투자…2나노 생산거점 완성 수순

"아이폰·패드 따로 사는 것보다 낫다"…애플 '아이폰 듀오' 국내 출시

AI 글래스 ‘몰카’, 국감서 시연...배경훈 "범부처 대책 마련하겠다"

정용진 신세계 회장, 이마트 대표 복귀…김홍극과 각자대표 체제

ZDNet Power Center

Connect with us

ZDNET Korea is operated by Money Today Group under license from Ziff Davis. Global family site >>    CNET.com | ZDNet.com
  • 회사소개
  • 광고문의
  • DB마케팅문의
  • 제휴문의
  • 개인정보취급방침
  • 이용약관
  • 청소년 보호정책
  • 회사명 : (주)메가뉴스
  • 제호 : 지디넷코리아
  • 등록번호 : 서울아00665
  • 등록연월일 : 2008년 9월 23일
  • 사업자 등록번호 : 220-8-44355
  • 주호 : 서울시 마포구 양화로111 지은빌딩 3층
  • 대표전화 : (02)330-0100
  • 발행인 : 김경묵
  • 편집인 : 김태진
  • 개인정보관리 책임자·청소년보호책입자 : 김익현
  • COPYRIGHT © ZDNETKOREA ALL RIGHTS RESERVED.